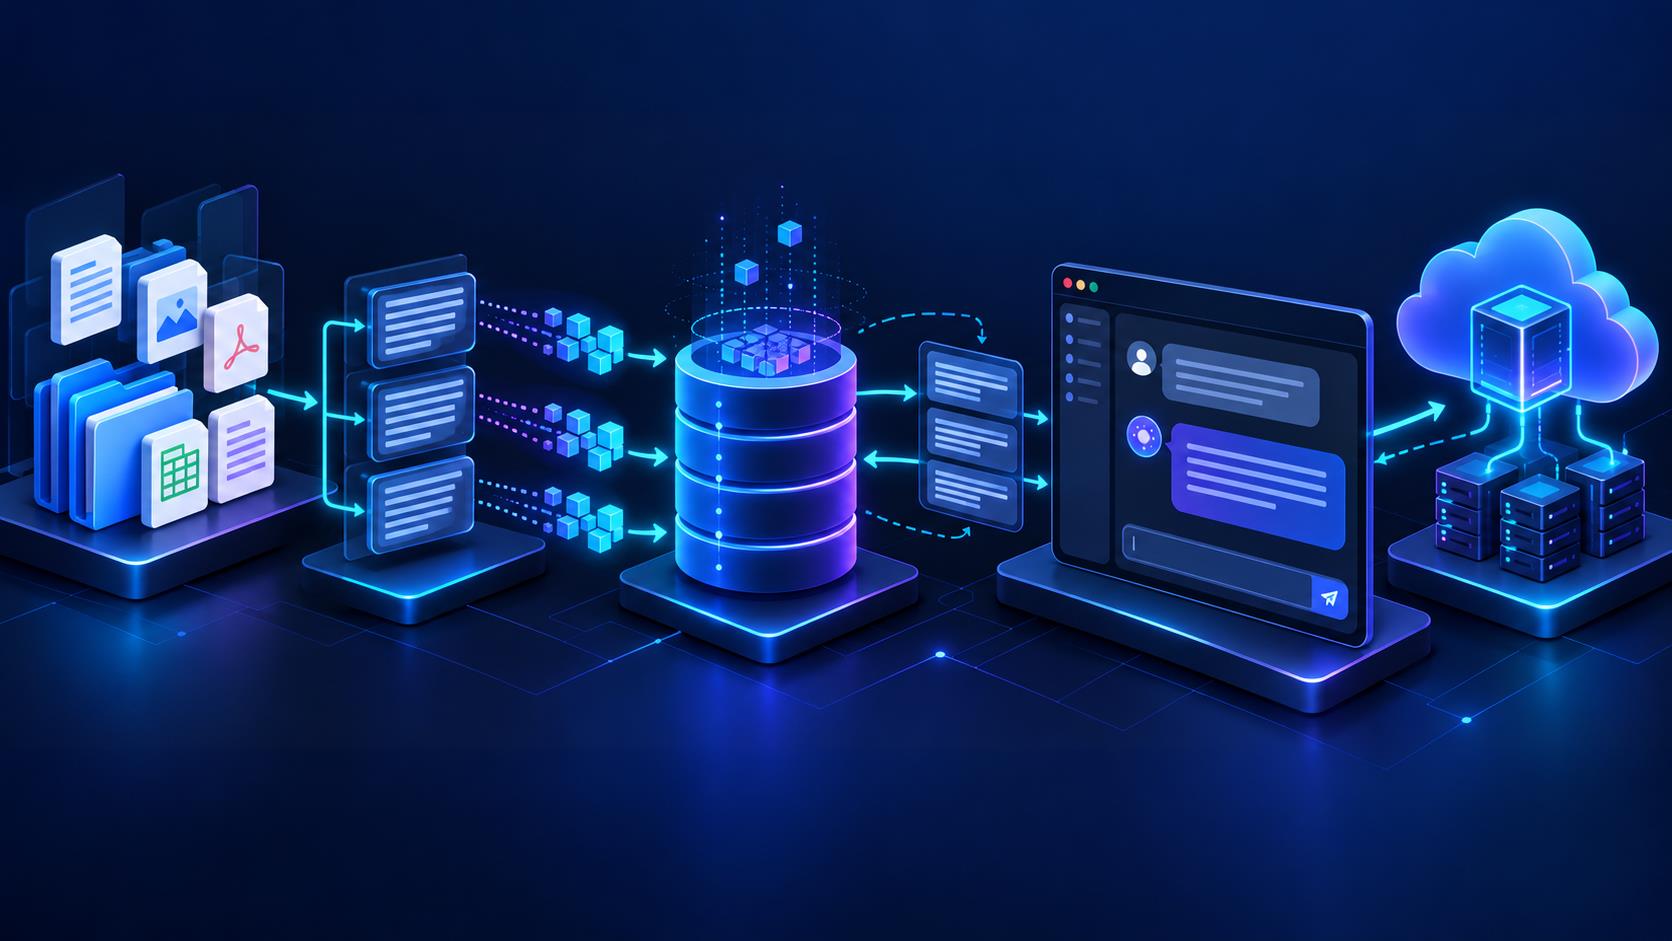
先理解整体架构
AnythingLLM 把模型调用与知识库检索拆开。KingFlow AI 负责聊天生成,文档处理、嵌入和检索由 AnythingLLM 及其组件完成。
| 组件 | 职责 | 关键边界 |
|---|---|---|
| 用户和工作区 | 组织对话 提示词和访问范围 | 不同工作区可以选择不同聊天模型 |
| 文档处理 | 解析 分块并准备索引内容 | 上传文件不等于已经进入知识库 |
| 嵌入模型 | 把文本转换为可检索向量 | 系统级配置 变更后需要重新嵌入 |
| 向量数据库 | 保存向量并检索相关片段 | 默认方案适合起步 大规模数据需单独规划 |
| KingFlow AI | 通过 OpenAI 兼容接口生成回答 | 聊天模型不会自动承担文档嵌入 |
开始前的准备
- 在 KingFlow AI 控制台创建以 sk- 开头的 API Key,并确认余额、套餐或模型分组可用。
- 从模型列表复制要使用的完整模型 ID,不要凭印象缩写名称。
- 决定使用 AnythingLLM Desktop 还是 Docker。单人本机体验可选 Desktop,多人和浏览器访问应选 Docker。
- 为 Docker 版准备持久化目录、备份位置和 ****S 反向**;首次联调不要导入敏感文档。
- 选择嵌入模型。新部署可以先用 AnythingLLM 内置嵌入器,中文资料较多时要用真实语料验证召回质量。
先验证 KingFlow 接口
curl https://api.**nju**shen.com/v1/chat/completions \
  -H "Authorization: *earer ${KINGFLOW_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "<KingFlow控制台中的完整模型ID>",
    "messages": [{"role": "user", "content": "只回复:连接成功"}],
    "stream": false
  }'
成功响应应包含 choices 数组和模型文本。
部署 Docker 版本
export STORAGE_LOCATION=$HOME/anythingllm && \
mkdir -p "$STORAGE_LOCATION" && \
touch "$STORAGE_LOCATION/.env" && \
docker run -d -p 3001:3001 \
  --cap-add SYS_***** \
  --name anythingllm \
  -v "$STORAGE_LOCATION:/app/server/storage" \
  -v "$STORAGE_LOCATION/.env:/app/server/.env" \
  -e STORAGE_DIR="/app/server/storage" \
  mintplexla*s/anythingllm:latest
打开 http://localhost:3001。持久化卷是必要项。
配置 Generic OpenAI
| 设置项 | 填写内容 | 说明 |
|---|---|---|
| LLM Provider | Generic OpenAI | 使用可自定义端点的 OpenAI 兼容连接器 |
| *ase **L | https://api.**nju**shen.com/v1 | 填写到 /v1 不要追加 /chat/completions |
| API Key | sk-你的密钥 | 不要手工添加 *earer 前缀 |
| Chat Model | 完整模型 ID | 必须与 KingFlow 控制台一致 |
| Token Context Window | 按模型能力填写 | 不确定时保守设置并通过长对话验证 |
- 打开 AnythingLLM,进入 Settings → AI Providers → LLM。不同版本的菜单文字可能略有差异。
- 选择 Generic OpenAI,然后按配置表填写 *ase **L、API Key、模型 ID 和上下文窗口。
- 保存后发起一条短对话。若界面只验证连接但没有真实生成,仍要在工作区完成一次实际请求。
- 创建工作区后打开工作区设置,确认它使用 KingFlow 模型;工作区级选择可以覆盖系统默认聊天模型。
单独配置嵌入模型
| 层级 | 作用 | 本教程选择 |
|---|---|---|
| 聊天模型 | 理解问题并生成最终回答 | 本教程接入 KingFlow AI |
| 嵌入模型 | 把问题和文档片段转换为向量 | 可使用内置模型或受支持的独立服务 |
| 向量数据库 | 保存向量并返回相似片段 | 默认 LanceD* 可快速起步 |
嵌入模型是系统级设置。更换嵌入器后应删除旧索引并重新嵌入。
创建工作区并导入文档
- 新建工作区并使用清晰名称,例如 产品手册测试库。先不要把多个部门资料混在一起。
- 在工作区设置中写一段简短系统提示词,要求回答优先依据工作区资料,无法确认时明确说明。
- 上传一份小型、结构清晰、无敏感信息的测试文档。上传完成后把文档嵌入或移动到该工作区。
- 等待索引完成,再检查文档是否显示在工作区已嵌入列表中。只有出现在这里的资料才会参与跨会话 RAG。
- 用三类问题验证:文档中明确存在的事实、需要组合两个段落的信息、文档中不存在的内容。
- 要求回答列出依据或引用,再人工打开原文核对。模型回答不能代替原始文件。
| 方式 | 可见范围 | 适用场景 | 注意事项 |
|---|---|---|---|
| 聊天附件 | 当前线程临时使用 | 短文档或一次性分析 | 可能把全文放入上下文 |
| 工作区嵌入 | 工作区内所有线程可检索 | 长期知识库 | 依赖分块和向量召回 |
| 文档固定 | 把已嵌入文档全文加入上下文 | 极重要且能完整放入上下文的文件 | 速度和 Token 成本更高 |
验证检索增强问答
- 精确事实题:询问文档中的日期、型号或条款,确认答案和原文一致。
- 组合题:要求综合两个章节,检查是否遗漏条件和例外。
- 否定题:询问资料中不存在的数字,合格回答应说明未找到依据。
- 更新题:替换文档后重新嵌入,确认旧答案不再出现。
- 权限题:用无权访问该工作区的普通用户登录,确认看不到工作区和历史对话。
| 现象 | 可能原因 | 优化方向 |
|---|---|---|
| 召回不到 | 文档未嵌入 查询过于宽泛 或嵌入模型不适合中文 | 确认文档状态 用更具体的问题并抽样检查中文召回 |
| 答非所问 | 片段噪声较多 相似度阈值或片段数量不合适 | 先缩小文档范围 再逐步调整检索参数 |
| 长文遗漏 | 重要内容跨越分块边界 | 优化标题和段落结构 调整分块后重新嵌入 |
| 回答过度自信 | 系统提示词未限制无依据回答 | 要求指出依据 无资料时明确拒答 |
| 成本偏高 | 历史过长 固定文档过大 或检索片段过多 | 新建会话 取消不必要固定文档并减少上下文 |
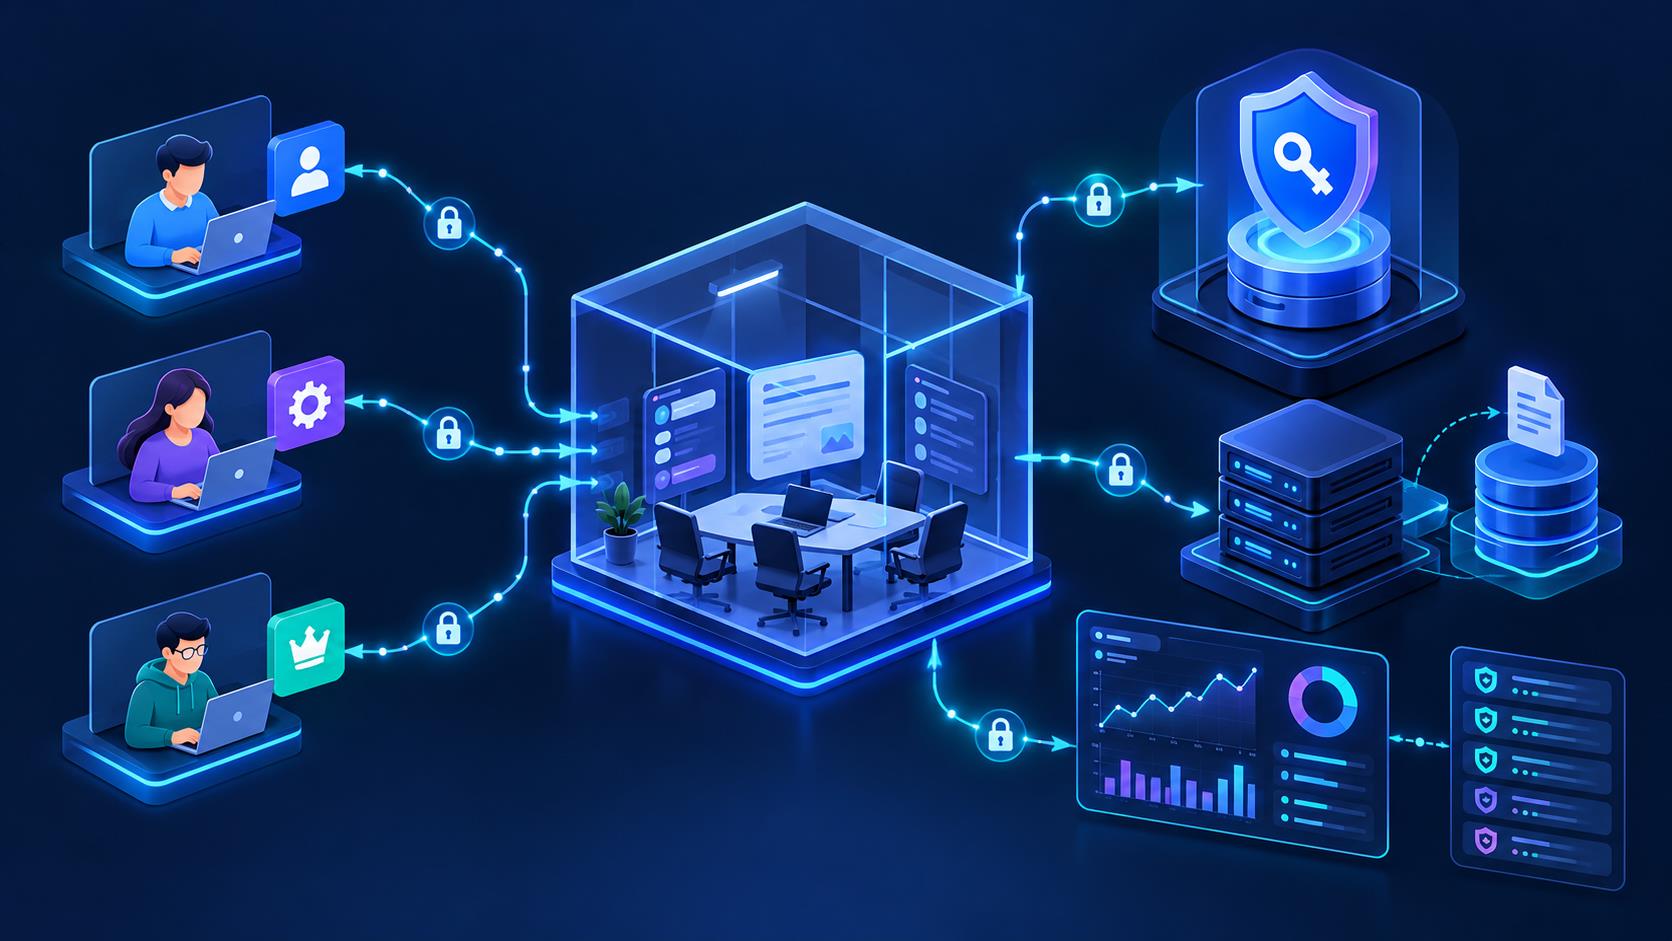
设置多人访问和安全边界
- Docker 单人模式可以设置实例密码;需要按用户授权时再启用多人模式。多人模式一旦开启不能退回单人模式,操作前先备份。
- 多人模式包含 *****、Manager 和 Default 等角色。普通用户只应加入其工作所需的工作区。
- 嵌入到工作区的文档会对所有有权访问该工作区的用户可用。敏感级别不同的资料应拆分工作区。
- 持久化目录包含数据库、文档、向量数据和 .env 中的密钥。限制主机权限并加密备份,不要使用 chmod 777 解决权限问题。
- 对外提供服务时使用 ****S、强密码、最小开放端口和受控反向**。不要直接把 3001 端**露到不可信网络。
- 为测试、生产和不同团队使用独立 KingFlow Key,并设置合理额度、有效期和监控,便于撤销与审计。
备份和更新
- 更新镜像前备份整个持久化目录。
- 记录版本、模型、向量库和检索参数。
- 更新后验证登录、权限、对话和文档检索。
- 定期做恢复演练。
常见故障排查
| 现象 | 常见原因 | 处理方法 |
|---|---|---|
| 401 未授权 | 密钥错误 已停用或额度不可用 | 重新复制密钥并检查控制台状态 |
| 404 模型不存在 | 模型 ID 错误或当前分组不支持 | 从 KingFlow 控制台复制完整 ID |
| 503 暂时不可用 | 上游通道繁忙或暂无可用账号 | 稍后有限重试 或切换已授权模型 |
| Generic OpenAI 连接失败 | *ase **L 缺少 /v1 或多写了具体路径 | 改为 https://api.**nju**shen.com/v1 |
| 对话正常但文档问答失败 | 聊天模型已连接 但文档未嵌入 | 配置嵌入器并把文档加入工作区 |
| 更换嵌入器后检索异常 | 新旧向量不兼容 | 删除旧索引并用新嵌入器重新嵌入 |
| 容器重建后数据消失 | 未挂载持久化存储 | 恢复备份并正确挂载 /app/server/storage |
| 容器无法写入存储 | 主机目录权限和容器 UID GID 不匹配 | 把目录所有权授予对应 UID GID 不要放宽到 777 |
上线检查清单
- KingFlow 最小 curl 请求已经成功。
- Generic OpenAI *ase **L 使用 https://api.**nju**shen.com/v1。
- 聊天模型 ID 与控制**全一致,上下文窗口设置经过验证。
- 嵌入模型和向量库已独立配置,测试文档已经嵌入工作区。
- 事实题、组合题、否定题、更新题和权限题均通过。
- 多人模式启用前已备份,角色和工作区成员遵循最小权限。
- 存储卷、.env、API Key、日志和备份均受到保护。